85 % des relevés de créanciers traités sans intervention humaine : comment Moulton Law Group a automatisé son courrier entrant
Vue d’ensemble
Si vous avez déjà travaillé dans une structure de règlement de dettes ou de crédit à la consommation, vous savez à quoi ressemble le service courrier. Les clients déposent relevés, avis de recouvrement et offres de règlement sur un portail. Le personnel ouvre chaque document, détermine à quel client il appartient, identifie le compte créancier dans le CRM, lit le document pour en tirer le solde actuel, le numéro de compte, le paiement minimum, la date d’échéance et les éventuels changements de créancier, puis met à jour les bons champs dans Debt Manager, dépose le fichier dans le bon dossier de pièces jointes avec la bonne convention de nommage, et crée la bonne tâche de suivi si quelque chose cloche. Multipliez cela par des centaines de documents par semaine, et vous obtenez une équipe entière consacrée à de la pure saisie de données, que l’entreprise n’a pas d’autre choix que de continuer à financer.
Moulton Law Group nous a demandé de retirer ce travail des épaules de leur équipe. Nous avons conçu et construit un pipeline IA documentaire de bout en bout qui ingère les téléversements depuis trois canaux indépendants, classifie chaque page, identifie le client et le compte créancier précis, extrait les champs structurés, les recoupe avec l’enregistrement existant dans Debt Manager, applique les règles de champ exactes du cabinet (ce qui est mis à jour, ce qui n’est jamais touché, ce qui n’est renseigné que si le champ est vide), et réécrit l’ensemble dans le CRM avec le fichier attaché et les notes ajoutées.
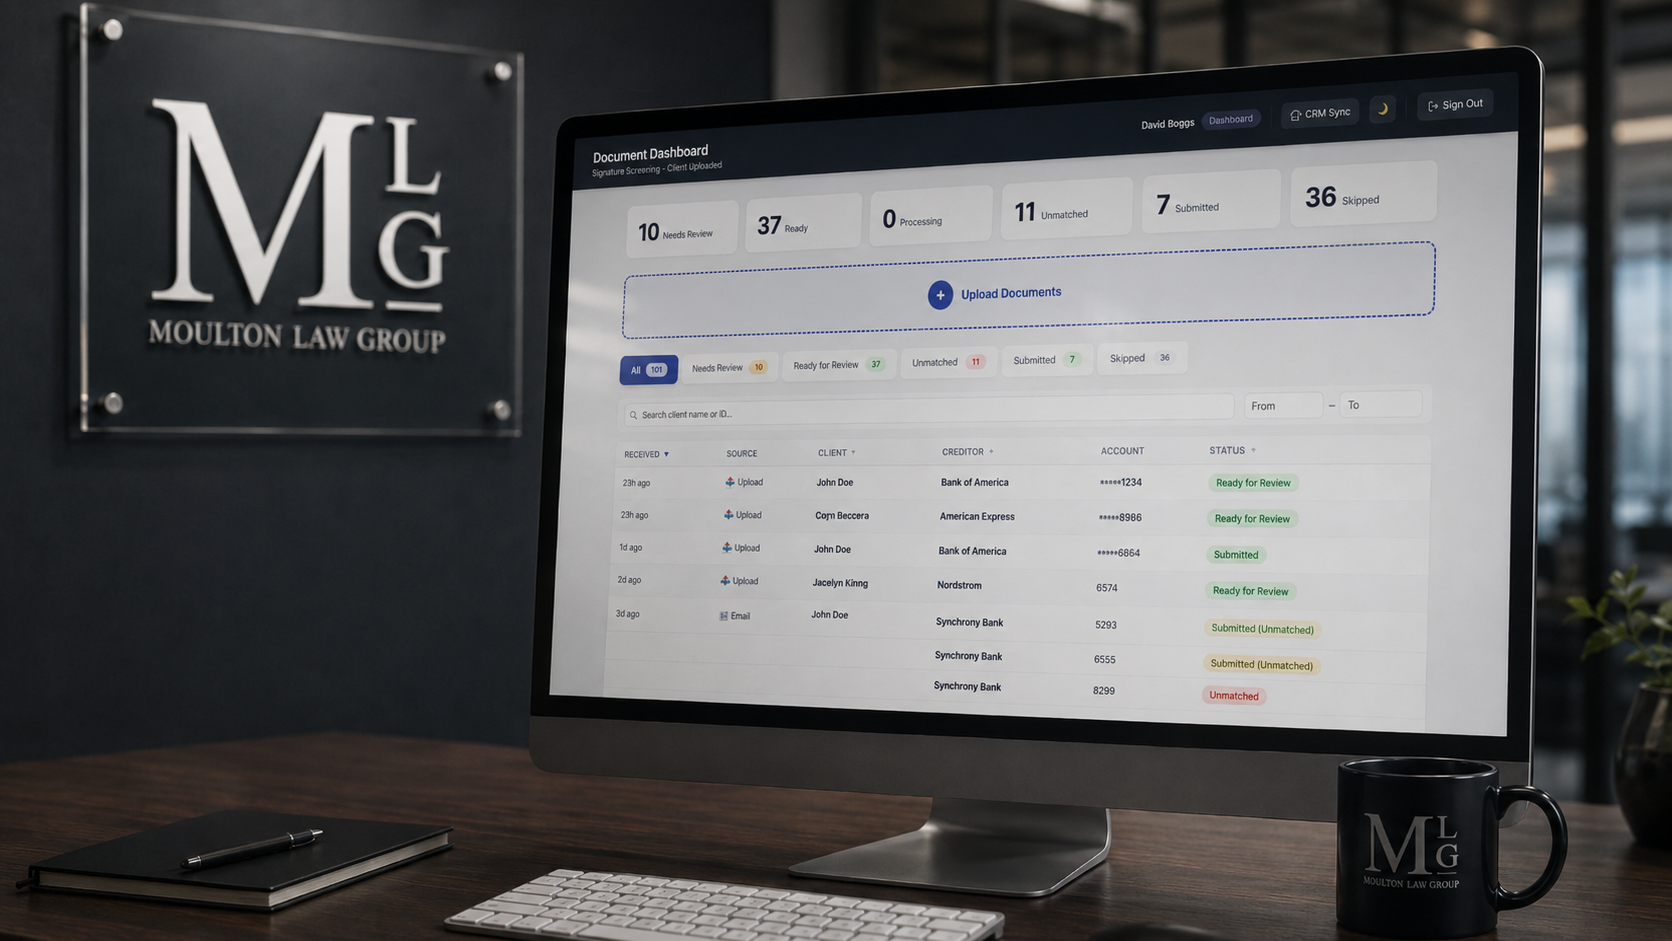
Quand l’IA est confiante, le travail passe de bout en bout sans que le personnel ne le touche. Quand la confiance baisse, le document tombe dans une file d’attente légère de vérification avec les données extraites préremplies, ce qui permet au personnel de vérifier en quelques secondes au lieu de tout refaire depuis zéro. En traitement réel, 85 % des cas passent de bout en bout sans intervention du personnel. 97,8 % des extractions IA sont acceptées par le personnel sans aucune modification de champ. Le pipeline pousse les documents vers Debt Manager avec un taux de succès des opérations CRM de 96,9 %, et seul 1 document sur 14 nécessite la moindre correction du personnel. L’équipe qui passait sa semaine sur de la saisie la consacre désormais aux 15 % de cas limites qui exigent réellement du jugement, et le système est conçu pour absorber les centaines de documents quotidiens qu’apportera le volume de production réel.
Contexte de l’entreprise
Moulton Law Group est un cabinet américain de règlement de dettes et de crédit à la consommation qui traite de gros volumes de correspondance de créanciers pour le compte de clients inscrits. Chaque jour, relevés, avis de recouvrement, offres de règlement et autres documents de créanciers arrivent via les téléversements depuis le portail client, les scans internes du personnel et les e-mails transférés. Chacun doit être rattaché au bon client, au bon compte créancier et aux bons champs dans Debt Manager (leur CRM), selon des règles strictes précisant quels champs peuvent être mis à jour et lesquels doivent rester intacts pour la conformité. Dans ce type d’opération, la rapidité et l’exactitude du traitement documentaire déterminent directement la vitesse à laquelle les règlements avancent et le niveau de protection du cabinet.
Le défi
Notre approche stratégique
Ce n’était pas le déploiement d’une simple fonctionnalité. C’était un pipeline opérationnel complet qui devait lire les documents avec précision, appliquer des règles métier strictes, s’intégrer en profondeur à Debt Manager, et rester sous supervision humaine à chaque soumission. Nous avons piloté la conception, la construction et l’intégration de bout en bout.
Phase 1 : coconception des règles de champ et de la taxonomie documentaire
Avant qu’un modèle ne touche à un document, nous nous sommes assis avec l’équipe Moulton pour extraire les règles métier exactes : quels champs peuvent être mis à jour, lesquels ne le peuvent jamais, lesquels ne le sont que sous conditions précises, comment traiter les comptes non inscrits, quels types de documents comptent et lesquels non, à quoi ressemble un « rapprochement évident » par rapport à ce qui exige le jugement du personnel. La sortie a été une spécification déterministe que le pipeline IA exécute de la même manière à chaque fois. L’objectif n’était pas « la précision de l’IA en général ». L’objectif était que « l’IA suive les règles exactes du cabinet, sans exception ».
Phase 2 : construire une couche d’ingestion unifiée sur trois canaux
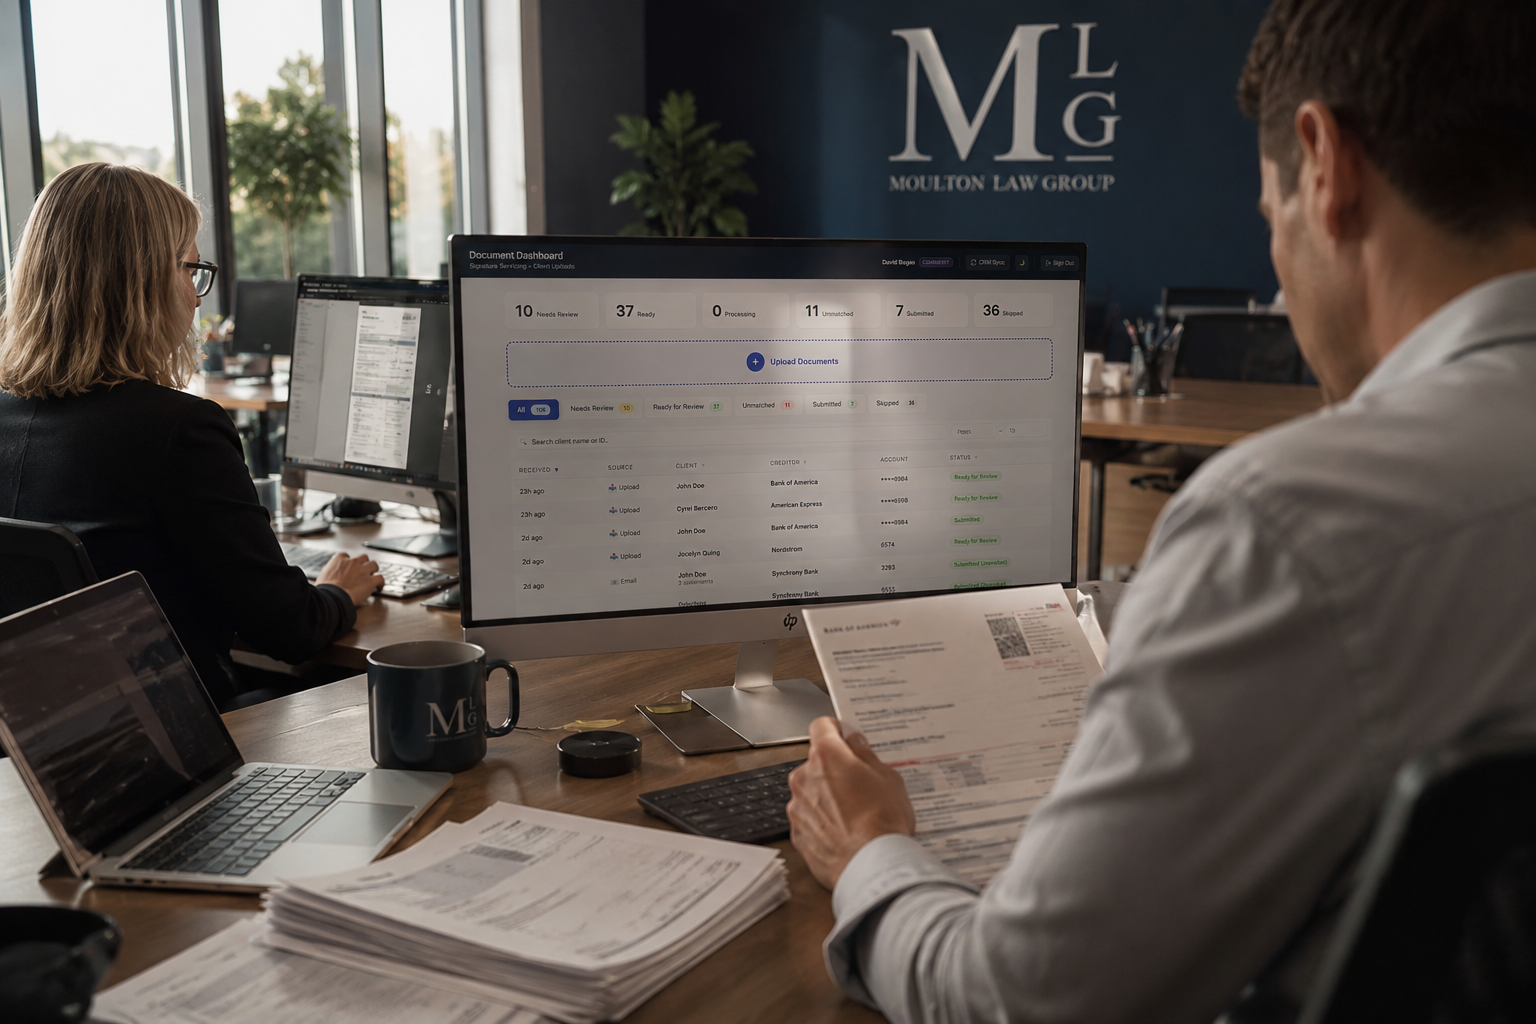
Nous avons construit un pipeline unique qui accepte les téléversements depuis trois sources indépendantes : un polling du CRM qui remonte les documents depuis l’activité du personnel dans Debt Manager, un tableau de bord où le personnel dépose directement relevés et scans de courrier, et un canal e-mail entrant propulsé par un transfert SendGrid. Les trois flux alimentent le même traitement en aval. Le personnel ne gère pas trois files d’attente. Il n’y en a qu’une.
Phase 3 : construire le moteur de classification et d’extraction
Chaque téléversement est découpé en pages, classé par type de document et rattaché à un client. Les relevés de créanciers sont extraits en champs structurés (solde actuel, numéro de compte, montant minimum dû, date d’échéance, nom du créancier, informations du demandeur et du codemandeur). Le moteur tourne à 94 % de confiance moyenne de classification tous documents confondus et 96 % sur les relevés de créanciers en particulier, sans aucune page tombant dans la catégorie de faible confiance où le personnel devrait tout recommencer.
Phase 4 : routage fondé sur la confiance, avec l’humain dans la boucle
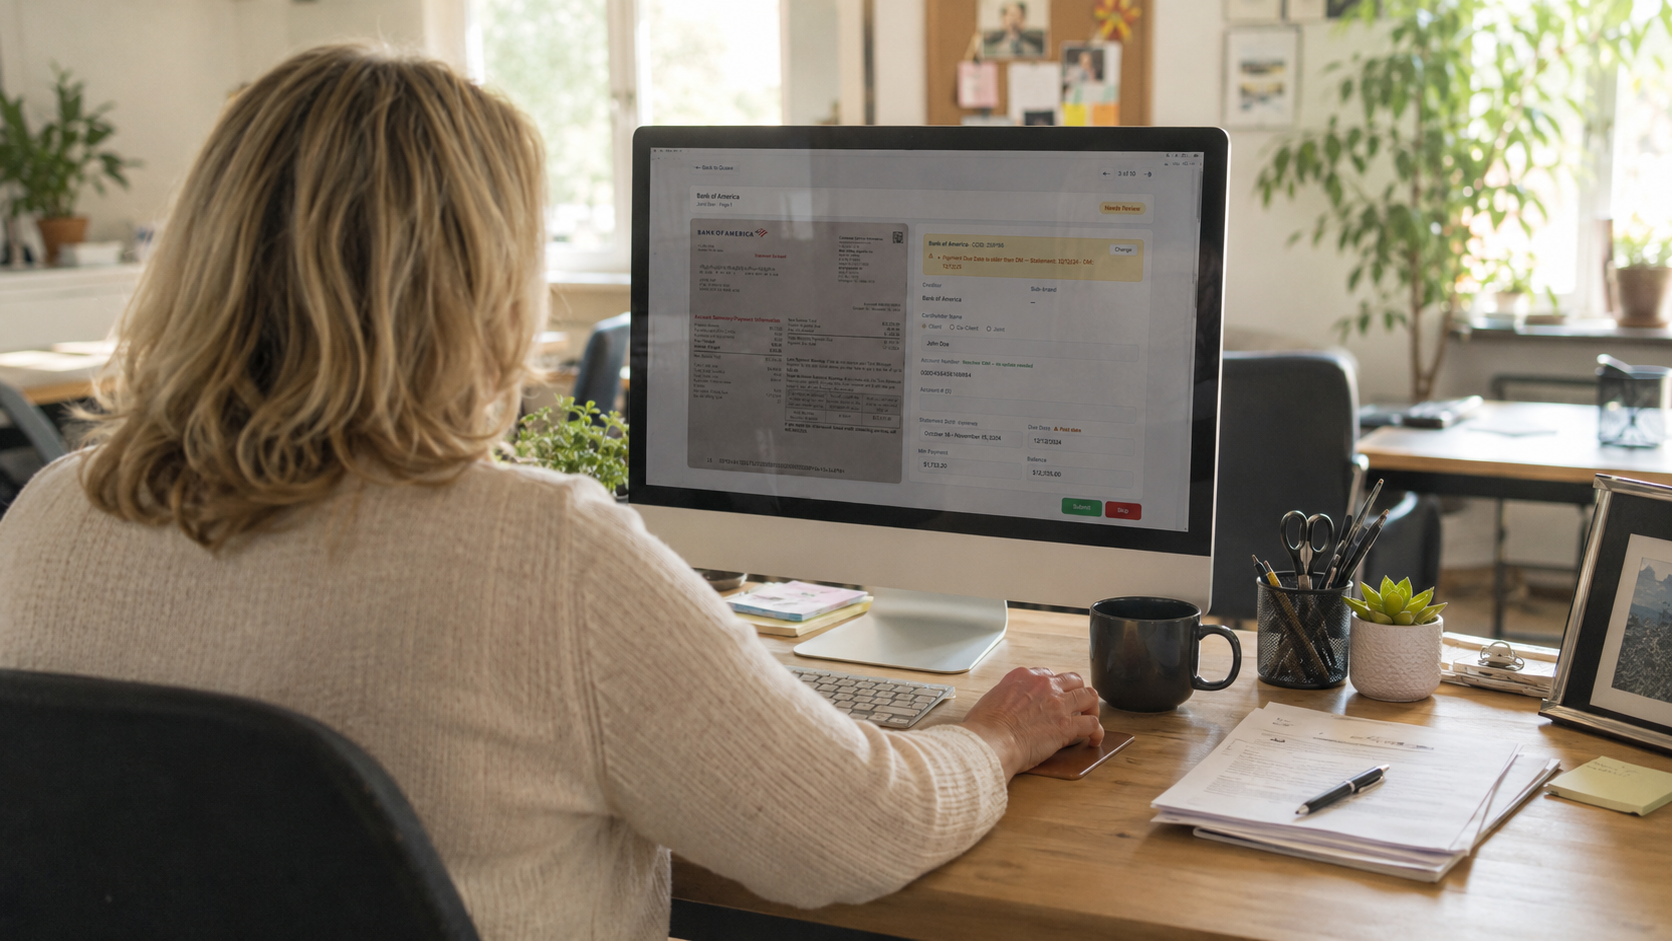
Tous les documents ne se lisent pas aussi clairement. Les pages à forte confiance sont automatiquement routées vers l’extraction. Les pages à confiance moyenne sont extraites mais signalées pour vérification par le personnel avant toute écriture. Quand le client ne peut pas être rattaché automatiquement, le document est routé vers le personnel pour affectation. Point crucial : aucun document n’atteint Debt Manager sans validation du personnel. Le système est rapide, mais il ne fonctionne jamais hors supervision humaine.
Phase 5 : intégration approfondie à Debt Manager
Quand un document est approuvé, le pipeline orchestre l’ensemble du workflow Debt Manager : recherche client, mise à jour du compte créancier, dépôt du fichier avec la bonne convention de nommage (mois plus créancier), création d’une note structurée, génération d’une tâche de suivi si nécessaire, et soumission finale. Environ 4,4 appels à l’API du CRM par document soumis, tous orchestrés par le pipeline, aucun touché par le personnel. Le système fonctionne avec un taux de succès des opérations CRM de 96,9 % sur chaque action envoyée à Debt Manager.
Solution : le pipeline documentaire Moulton
Résultats
Il s’agit de données opérationnelles réelles issues du traitement en production.
85 % des cas traités automatiquement sans intervention du personnel. L’IA gère l’ensemble du workflow (classification, extraction, préparation de la charge utile CRM, intégration) sur la grande majorité des soumissions. Le personnel reste dans la boucle à chaque validation, mais ne fait plus aucune saisie manuelle.
97,8 % des documents extraits acceptés sans aucune modification de champ. La qualité d’extraction de l’IA est suffisamment élevée pour que la vérification devienne un simple coup d’œil, plutôt qu’une réécriture. Seul 1 document sur 14 nécessite la moindre correction du personnel.
94 % de confiance moyenne de classification IA, 96 % sur les relevés de créanciers. Aucune page ne tombe dans la catégorie de faible confiance où le personnel devrait classifier depuis zéro. Le travail de vérification de l’équipe est réellement léger, ce n’est pas un « refaisons le travail de l’IA ».
96,9 % de taux de succès des opérations CRM. Sur des milliers d’appels API vers Debt Manager (ClientSearch, UpdateClientCreditor, PostAttachment, PostNote, CreateTask, Submit), le pipeline s’exécute avec une fiabilité proche du niveau production. Chaque document génère en moyenne 4,4 appels API, tous orchestrés par le pipeline, aucun touché par le personnel.
Aucun document n’atteint le CRM sans validation du personnel. La vitesse ne se paie pas au prix du contrôle. Chaque soumission passe par une vérification humaine avant que la moindre donnée ne touche Debt Manager.
Conçu pour passer à l’échelle avec les volumes de production. Le pipeline est architecturé pour absorber des centaines de documents quotidiens sans perte de performance ni dérive de précision. À mesure que le volume entrant augmente, la charge du personnel reste plate. Les effectifs auparavant financés pour la saisie sont désormais disponibles pour des tâches à plus forte valeur.
La charge de travail passe de la saisie à une vérification légère. L’équipe qui passait ses journées sur la classification manuelle, les recherches CRM et les mises à jour de champs les consacre désormais aux 15 % de cas limites qui exigent réellement du jugement.
Perspective du client
À retenir
Toutes les opérations de règlement de dettes, de crédit à la consommation et de services juridiques dans ce secteur subissent le même frein. Les documents arrivent. Quelqu’un doit les lire, les classer, les rattacher, les extraire et mettre à jour le CRM selon des règles strictes sur ce qui peut être touché et ce qui ne le peut pas. C’est critique pour la conformité, répétitif, et de la pure saisie. Et cela évolue linéairement avec le volume, ce qui veut dire plus de clients égale plus d’effectifs égale plus d’encadrement égale plus de surface d’erreur.
La réponse n’est pas l’OCR. L’OCR lit du texte. La réponse, c’est un pipeline complet qui classifie le document, identifie le client et le compte, extrait des champs structurés validés, applique les règles de champ exactes du cabinet, orchestre l’intégration au CRM et reste sous supervision humaine à chaque soumission. Bien conçu, il absorbe toute la charge mécanique tout en laissant chaque décision de conformité entre des mains humaines.
Résultat : 85 % des cas traités de bout en bout sans que le personnel ne les touche, 97,8 % des extractions acceptées sans aucune modification, et un taux de succès des opérations CRM de 96,9 %, le tout sous supervision humaine à chaque soumission. L’équipe qui passait sa semaine sur la saisie du courrier la consacre désormais aux cas limites qui ont réellement besoin d’elle.
Si votre équipe fait le même travail mécanique sur chaque document qui passe la porte, et que ce travail consomme des effectifs que vous préféreriez déployer ailleurs, voici à quoi ressemble une vraie solution.
Lire d'autres études de cas


Libérez le potentiel de l'IA pour transformer votre entreprise
Automatisez vos opérations grâce à des solutions IA conçues sur mesure. Du service client aux ventes, nous aidons vos équipes à se concentrer sur les activités à plus forte valeur ajoutée.

font confiance